Ja, gepseudonimiseerde gegevens blijven persoonsgegevens onder de GDPR, omdat heridentificatie mogelijk blijft met afzonderlijk bewaarde informatie (artikel 4(5) en overweging 26). Het verwijderen van namen kan de blootstelling wezenlijk verkleinen zonder dat de werkende dataset buiten het gegevensbeschermingsrecht valt. De lastige vraag is niet of een document zichtbare namen bevat. Het is of de organisatie kan aantonen dat haar transformatie, toegangscontroles en beoogd gebruik het identificatierisico voldoende verkleinen voor de verwerking die zij voorstelt. Een overtuigende pseudonimiseringsstrategie heeft daarom meer nodig dan een maskeringstool: zij heeft bewijs van scheiding, evenredige waarborgen en een gedocumenteerde juridische beoordeling nodig. Voor besluitvormers die AI-documentworkflows goedkeuren, is het verdedigbare standpunt om pseudonimisering te behandelen als een bestuurd proces, niet als een vrijstelling van naleving.
Wat bedoelt de GDPR met pseudonimisering?
Pseudonimisering betekent het transformeren van persoonsgegevens zodat het toeschrijven ervan aan een specifieke persoon aanvullende informatie vereist die afzonderlijk onder waarborgen wordt bewaard. De pseudonimiseringsrichtlijnen van de EDPB lichten deze definitie toe onder artikel 4(5), een uitdrukkelijk gedefinieerd begrip in de GDPR toen de verordening van toepassing werd op 25 mei 2018.
De definitie betreft hoe een organisatie gegevens verwerkt en beschermt, niet louter hoe het resulterende document eruitziet. Een bestand met gecodeerde namen kan nog steeds het praktische doel van pseudonimisering missen als de ontvanger de bijbehorende identiteiten gemakkelijk kan achterhalen.
De voorwaarden achter de definitie
Een verdedigbare implementatie adresseert deze samenhangende vereisten:
- Transformeer de gegevens. Vervang of wijzig identificerende waarden zodat het werkmateriaal de informatie niet rechtstreeks aan de persoon toeschrijft.
- Scheid de toeschrijvingsinformatie. Houd de koppelingstabel, herstelsleutel of gelijkwaardige informatie apart van de getransformeerde dataset.
- Bescherm de route terug naar identiteit. Gebruik technische en organisatorische maatregelen tegen ongeoorloofde toeschrijving, waaronder beperkingen op wie de oorspronkelijke waarden kan herstellen.
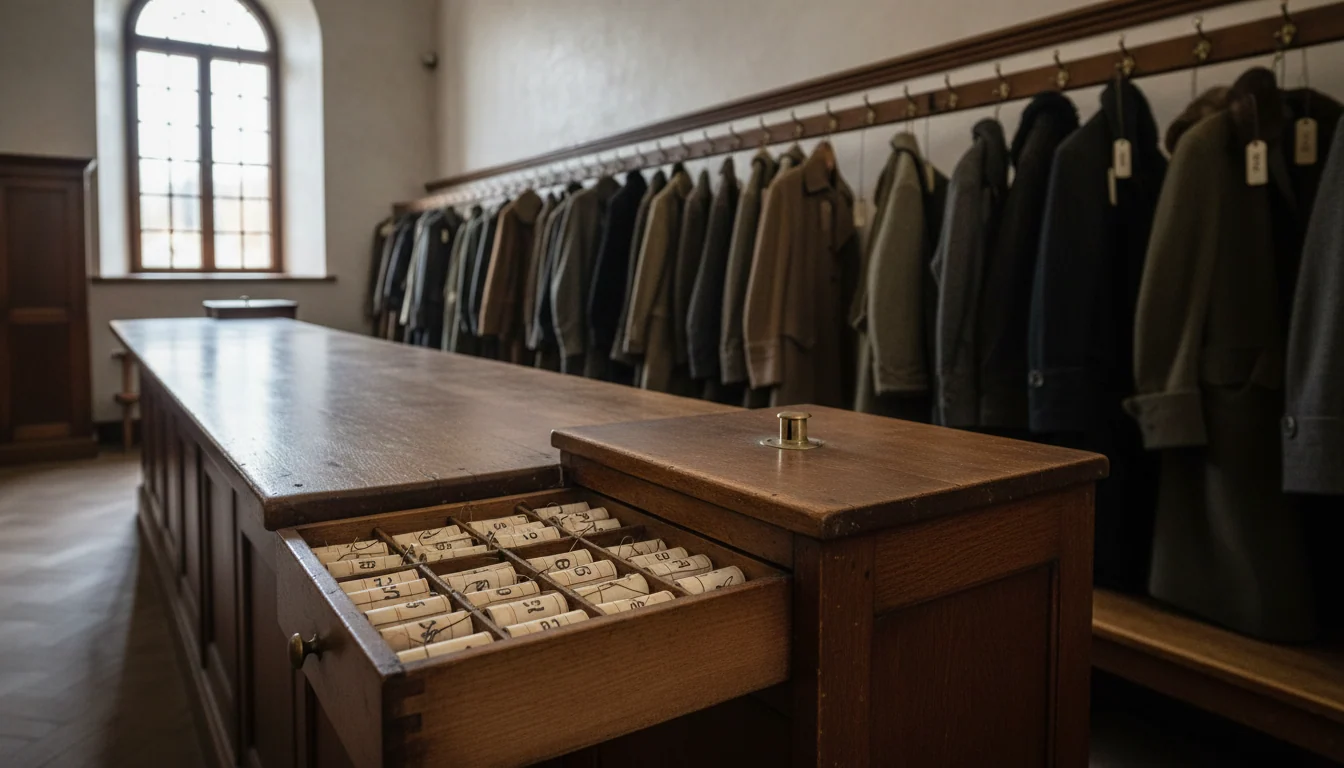
Denk aan een garderobe. Een genummerd kaartje aan een jas identificeert op zichzelf de eigenaar niet, maar met de bijpassende strook kan de garderobe de jas koppelen aan de persoon die hem ophaalt. De nuttige analogie is niet dat namen cijfers worden. Het is dat het koppelingsmechanisme zijn eigen bescherming nodig heeft.
De analogie heeft ook een grens: documenten kunnen identiteit via hun inhoud onthullen, zelfs wanneer hun labels zijn gewijzigd. Een kenmerkend verslag van een incident kan iemand identificeren zonder enige opzoektabel.
Professionele documentverwerking omvat daarom het beschermen van zowel de tekst als de informatie die deze opnieuw aan een persoon koppelt.
Een waarborg, geen afzonderlijke juridische categorie
Pseudonimisering beschrijft een beschermend proces. Het creëert geen tussencategorie van informatie die organisaties kunnen verwerken zonder de gewone discipline van gegevensbescherming.
Toets voor projectgoedkeuring: Identificeer waar de toeschrijvingsinformatie wordt bewaard, wie er toegang toe heeft en wat de ontvanger van de werkgegevens belet om deze te verkrijgen.
Als die vragen geen duidelijke antwoorden hebben, heeft de organisatie substitutie aangetoond, niet noodzakelijk effectieve scheiding. Dat onderscheid bepaalt hoeveel vertrouwen besluitvormers in de waarborg moeten stellen.
Zijn gepseudonimiseerde gegevens nog steeds persoonsgegevens onder de GDPR?
Ja, een werkende dataset blijft persoonsgegevens wanneer afzonderlijk bewaarde informatie de organisatie in staat stelt deze opnieuw aan personen te koppelen. De richtlijnen van de UK ICO over onderzoekswaarborgen leggen uit dat gepseudonimiseerde gegevens iemand niet identificeren uit de dataset alleen, maar dat identificatie mogelijk blijft door naar aanvullende informatie te verwijzen.
Dat is Britse toezichtsrichtlijn, geen vervanging voor een EU-juridische beoordeling. Het illustreert niettemin het operationele onderscheid duidelijk: het verwijderen van directe identificatoren en het verwijderen van redelijke identificatiemogelijkheden zijn verschillende uitkomsten.
Gepseudonimiseerde en geanonimiseerde gegevens onder de GDPR
- Status onder de GDPR — Gepseudonimiseerde gegevens: Blijven persoonsgegevens; Geanonimiseerde gegevens: Buiten de GDPR waar identificatie niet langer redelijkerwijs waarschijnlijk is
- Heridentificatiemateriaal — Gepseudonimiseerde gegevens: Afzonderlijk bewaard, zoals een sleutel, koppelingstabel of kluis; Geanonimiseerde gegevens: Er wordt geen aanvullende informatie bewaard die identificatie mogelijk maakt
- Omkeerbaar — Gepseudonimiseerde gegevens: Ja, met de afzonderlijk bewaarde informatie; Geanonimiseerde gegevens: Niet bedoeld
- Typisch gebruik — Gepseudonimiseerde gegevens: Werkgegevens onder beveiligingswaarborgen; Geanonimiseerde gegevens: Statistieken, onderzoeksresultaten en vrijgegeven datasets, onder voorbehoud van een effectieve identificatierisicobeoordeling
- Gevolg voor verplichtingen — Gepseudonimiseerde gegevens: GDPR-verplichtingen gelden in het algemeen, met verminderd risico; Geanonimiseerde gegevens: Verplichtingen vervallen in het algemeen waar het identificatierisico voldoende gering is
De tabel beschrijft beoogde operationele modellen, geen automatische classificaties. Een onderzoeksresultaat wordt niet anoniem omdat het als statistisch rapport wordt gepubliceerd, en een vrijgegeven dataset wordt niet anoniem omdat de uitgever een naamkolom heeft verwijderd.
Omkeerbaarheid is een belangrijk waarschuwingssignaal, maar het is niet de volledige identificatietoets. Het vernietigen van een opzoektabel vestigt geen anonimiteit als iemand identiteit kan afleiden uit de overige attributen.
Beoordeel realistische identificatieroutes
Een degelijke beoordeling houdt rekening met de inspanning die nodig is om iemand te identificeren, de informatie die beschikbaar is voor de betrokken partijen en de technologie die zij redelijkerwijs zouden kunnen gebruiken. Kosten, tijd en technologische ontwikkelingen zijn van belang omdat een identificatieroute die in de ene context onpraktisch is, in een andere realistisch kan zijn.
Beschouw een hypothetische dataset voor bedrijfsgezondheidszorg. Het vervangen van werknemersnamen door codes behoudt het vermogen van de organisatie om records opnieuw te koppelen via haar personeelskoppeling. Het verwijderen van die koppeling zou de vraag niet beslechten als een kenmerkende rol- en incidentbeschrijving een werknemer nog steeds zou identificeren.
De ICO beveelt aan deze beschermende technieken zo vroeg mogelijk toe te passen, idealiter vóór gebruik voor onderzoek. Operationeel betekent dat het bepalen van de beoogde identificatiegrens voordat werkkopieën worden verspreid, in plaats van te proberen de controle terug te krijgen na verspreiding.
Als het team de output kan herleiden met een bestand dat het in handen heeft, houd dan rekening met verplichtingen rond persoonsgegevens. Als dat niet kan, beoordeel dan andere identificatieroutes voordat u de output als anoniem bestempelt.
Welke technische methoden gelden als pseudonimisering?
De sterkte van een methode hangt af van het aanvalsmodel, de koppeling die de analyse vereist en de bescherming van het geheim. Het vervangingsformaat alleen zegt weinig. ENISA's guidance on pseudonymisation techniques and best practices identificeert brute-force-, dictionary-search- en guesswork-aanvallen, naast technieken waaronder random values, keyed hashing, tokenisatie en encryptie.
Veelvoorkomende pseudonimiseringsmethoden en hun afwegingen
- Willekeurige vervanging met een lookup-tabel — Hoe het werkt: vervangt elke identificator door een willekeurige waarde die apart wordt vastgelegd; Koppelbaarheid tussen records: geen tussen documenten wanneer tokens onafhankelijk per document worden gegenereerd; Belangrijkste te beheersen risico: de tabel wordt de her-identificatiesleutel en vereist afzonderlijke bescherming
- Deterministische tokens met een keyed hash of MAC — Hoe het werkt: dezelfde invoer en hetzelfde geheim produceren hetzelfde token; Koppelbaarheid tussen records: ja, binnen het gedefinieerde bereik; Belangrijkste te beheersen risico: correlatie tussen records en compromittering van het geheim
- Vault-gebaseerde tokenisatie — Hoe het werkt: een vault geeft tokens uit en onderhoudt hun relatie tot de oorspronkelijke waarden; Koppelbaarheid tussen records: stabiel of documentspecifiek, afhankelijk van het uitgiftebeleid; Belangrijkste te beheersen risico: vault-permissies en toegangslogging
- Encryptie van identificatoren — Hoe het werkt: versleutelt identificatoren onder een apart bewaarde sleutel; Koppelbaarheid tussen records: ja bij deterministische encryptie; gerandomiseerde encryptie hoeft gelijkheid niet te behouden; Belangrijkste te beheersen risico: compromittering van de sleutel stelt herleidbare identificatoren bloot
- Generalisatie van quasi-identificatoren — Hoe het werkt: vermindert precisie, zoals het vervangen van exacte leeftijden door leeftijdsgroepen; Koppelbaarheid tussen records: geen koppelmethode; Belangrijkste te beheersen risico: zeldzame combinaties kunnen identificerend blijven
Generalisatie speelt een complementaire rol. Op zichzelf vermindert het doorgaans de precisie van onthullende attributen die vervanging van identificatoren onaangetast laat, waardoor het het beste werkt naast een vervangingsmethode in plaats van als vervanging ervan.
Willekeurige vervanging is nuttig wanneer een document intern consistente verwijzingen nodig heeft maar geen verbinding met andere documenten. Deterministische tokens ondersteunen continuïteit binnen een gedefinieerde analyse, maar onthullen tegelijkertijd dat overeenkomende records dezelfde persoon betreffen. Die afweging is de centrale ontwerpkeuze: elke eenheid van koppeling die u behoudt is een eenheid van correlatie die een aanvaller ook kan gebruiken.
Kies de minimaal noodzakelijke koppeling
Platte hashes van voorspelbare namen zijn een zwakke ontwerpkeuze omdat een aanvaller waarschijnlijke invoer kan testen. Keyed-methoden introduceren een beschermd geheim, maar dat geheim wordt vervolgens zelf een kritiek beveiligingsmiddel.
ENISA's technische guidance behandelt het onderliggende architectonische risico: het geheim en de dataset mogen niet in hetzelfde bestand worden behandeld, en opgeslagen geheimen hebben encryptie en goed sleutelbeheer nodig. Een verdedigbare implementatie gaat verder en produceert bewijs. Beperk herstelpermissies tot benoemde rollen, log elke sleuteltoegang en verwijder onveilige tijdelijke kopieën. Die registraties zijn wat pseudonimisering omvormt van een bewering tot een bestuurd proces dat een auditor kan verifiëren.
Definieer voor een analyseproject de legitieme koppelomvang voordat u tokens kiest. Teams die verbindingen tussen systemen afwegen kunnen planningscontext ontlenen aan PlotStudio AI's cross-platform analytics guide; de privacybeslissing blijft of die verbindingen noodzakelijk zijn voor het goedgekeurde doel, en die afwegingstoets moet worden gedocumenteerd in plaats van verondersteld.
Waar continuïteit niet nodig is, zijn per-document gerandomiseerde tokens een meer terughoudende standaard. Geen enkele identificatortechniek voorkomt gevolgtrekking uit een zeldzame combinatie van resterende attributen, en daarom horen methodekeuze, geheimbehandeling en koppelomvang allemaal thuis in hetzelfde geschreven dossier.
Welke wettelijke verplichtingen gelden nog voor gepseudonimiseerde gegevens?
Gepseudonimiseerde records blijven persoonsgegevens, dus de kern-GDPR-verplichtingen blijven volledig van toepassing. Article 25 of the GDPR noemt pseudonimisering als een voorbeeld van een beschermende maatregel en vereist waarborgen die evenredig zijn aan de verwerkingscontext en de risico's. Het biedt geen safe harbour: de organisatie moet nog steeds uitleggen waarom zij de gegevens verwerkt, hoe zij mensen beschermt en wie verantwoordelijk is.
Een representatie van een record met een lager risico vervangt die uitleg niet.
Verplichtingen vertaald naar operationele beslissingen
- Rechtmatige verwerking. Stel een passende rechtsgrond vast voor elk doel. Een beschermende transformatie rechtvaardigt op zichzelf niet het verzamelen of gebruiken van informatie.
- Privacy by design en by default. Beslis welke informatie noodzakelijk is, welke mensen toegang nodig hebben en wat de standaardconfiguratie toestaat.
- Passende beveiliging. Bescherm de werkdataset en de toeschrijvingsinformatie door geschikte scheiding, permissies en herstelcontroles.
- Rechten van betrokkenen. Onderhoud werkbare procedures voor inzage, rectificatie, wissing, beperking, overdraagbaarheid en bezwaar, waar van toepassing, en honoreer de intrekking van toestemming waar de verwerking daarop berust.
Deze rechten gaan gepaard met voorwaarden en uitzonderingen; ze gelden niet voor elke verwerking op dezelfde wijze. Bezwaar tegen verwerking op basis van gerechtvaardigde belangen vereist een eigen belangenafweging in plaats van behandeling als een onvoorwaardelijke wisinstructie. Het documenteren van die afweging maakt deel uit van de verplichting, omdat de evenredigheidstoets van artikel 25 de stand van de techniek, de uitvoeringskosten, de aard, omvang, context en doeleinden van de verwerking en de risico's voor betrokkenen tegen elkaar afweegt. Het schrijft geen universeel tokenformaat of vaste technische drempel voor. Onze bespreking van privacy by design als een engineeringverplichting over de hele levenscyclus werkt het operationele gevolg uit: waarborgen vereisen onderhoud naarmate de verwerking verandert.
Wijs verantwoordelijkheid toe aan mensen en registraties
Wanneer een klant onze dienst gebruikt om professionele documenten te verwerken, is de klant doorgaans de verwerkingsverantwoordelijke en The Coding Company B.V. de verwerker, zoals gedefinieerd in de toepasselijke overeenkomst. Die contractuele rollen moeten overeenkomen met de daadwerkelijke verwerkingsafspraken, en een inzage- of wisverzoek kan zowel de werkregistratie als de bijbehorende attributiegegevens betreffen. Stel bewaar- en verwijderingsregels voor de mapping op naast die voor de dataset, houd rekening met toepasselijke uitzonderingen en bewaarplichten, en bewaar bewijs waaruit blijkt waarom de gekozen waarborgen op dat moment als evenredig werden beschouwd.
Governancegevolg: Een gepseudonimiseerd bestand heeft een verantwoordelijke eigenaar, een bewaarbeslissing en een route voor het afhandelen van rechten nodig, niet louter een technisch label.
Houd jurisdicties gescheiden. Het EU GDPR-kader geldt in de EU; de verplichtingen onder UK GDPR en de richtsnoeren van de ICO gelden in het VK, met hun eigen juridische context en handhaving.
Hoe werkt lokale pseudonimisering voor AI-documenten?
Lokale pseudonimisering vervangt identificerende waarden voordat goedgekeurde documentcontext een extern model bereikt, terwijl gecontroleerde herstelinformatie afzonderlijk wordt bewaard. Denk aan een advocatenkantoor dat een AI-samenvatting wil van een getuigenverklaring met de naam van de cliënt, de geboortedatum en het dossiernummer.
De volgende afbeelding illustreert de scheiding tussen bronmateriaal, getransformeerde invoer en geautoriseerd herstel. De juiste juridische omschrijving van de verzonden werktekst is gepseudonimiseerd, geen bewering dat identificatie onmogelijk is.
Een verdedigbare volgorde voor documentverwerking
- Identificeer relevante identificatoren. Neem namen, geboortedata en dossierverwijzingen op, samen met identificerende passages in vrije tekst. Een veldenlijst alleen kan de naam van een getuige die in het verhaal wordt herhaald, missen.
- Detecteer waarden lokaal vóór externe aanroepen. Pas de controle toe op het daadwerkelijk ingediende materiaal, inclusief herziene concepten en selecties. Het testen van een eerdere versie bepaalt niet wat er bij een latere aanvraag wordt verzonden.
- Vervang waarden consistent binnen het document. Behoud partijrollen zodat het model onderscheid kan maken tussen de cliënt, getuige en tegenpartij. Inconsistente placeholders kunnen ertoe leiden dat de samenvatting personen samenvoegt of verklaringen verkeerd toeschrijft.
- Houd de mapping afzonderlijk beperkt. Bewaar herstelinformatie buiten de ingediende context, met toegang beperkt tot geautoriseerde functies. Het bijvoegen van de opzoektabel bij dezelfde aanvraag ondermijnt de beoogde scheiding.
- Controleer de uitgaande context en stop mislukte aanvragen. Inspecteer wat er verzonden zal worden, in plaats van te vertrouwen op een eerdere geslaagde test. Behandel elke indiening als een nieuwe vrijgavebeslissing.
- Verzend alleen de noodzakelijke getransformeerde context. Sluit irrelevante bijlagen en omliggend dossiermateriaal uit. Onze workflow voor dataminimalisatie bij generatieve AI behandelt die selectiebeslissing.
- Beoordeel de output vóór lokaal herstel. Controleer toeschrijving, weglatingen en niet-onderbouwde verklaringen voordat u identiteiten weer koppelt. Herstel mag een niet-beoordeelde samenvatting niet omzetten in een definitieve professionele registratie.
Scheid privacycontroles van de kwaliteit van het opstellen
Een hulpmiddel zoals LegesGPT's AI legal document generator is relevant bij het overwegen van AI-ondersteunde opstelworkflows, maar de beslissing om een externe dienst te gebruiken blijft losstaan van de goedkeuring om dossiermateriaal openbaar te maken.
Als de controle mislukt, wordt er geen documenttekst naar een extern model verzonden. Dit is een pseudonimiseringslaag die risico vermindert zonder de resulterende persoonsgegevens uit het regelgevingskader te verwijderen; het gedocumenteerde gedrag ervan moet worden beoordeeld tegen het beoogde gebruik.
De bijbehorende video biedt aanvullende context over de workflow.
Leg vóór goedkeuring vast waar de mapping wordt opgeslagen, wie er toegang toe heeft en hoe een mislukte uitgaande controle wordt afgehandeld. Dat zijn toetsbare controlevragen, geen garanties over de juistheid van de resulterende juridische analyse.
Welke restrisico's en bewijsstukken moet u vereisen voordat u op pseudonimisering vertrouwt?
Keur de workflow pas goed nadat u het restrisico op identificatie, de rechtsgrondslag voor gebruik en bewijs dat de controles werken, heeft gedocumenteerd. Vragen van klanten en afgeschermde tekst gaan naar de AI-modellen die zij kiezen, en die aanbieders kunnen gegevens buiten de EU verwerken. Waar hoofdstuk V GDPR van toepassing is, hebben afspraken tussen aanbieder en klant een passend doorgiftemechanisme nodig, zoals een adequaatheidsbesluit of Standard Contractual Clauses.
Onze privacycontroles detecteren niet elke indirecte identificator en maken heridentificatie niet onmogelijk. Een functietitel, een plaats en een exacte datum kunnen naar een persoon verwijzen zonder dat zijn naam wordt vermeld.
Naar onze analyse moet de verwerkingsverantwoordelijke het resterende risico expliciet beoordelen en aanvaarden in plaats van dat oordeel aan het hulpmiddel over te laten. De relevante vraag is of de voorgestelde waarborgen toereikend zijn voor deze ontvanger, deze dataset en dit doel.
Een belangenafweging is geen beveiligingschecklist
De aankondiging door de EDPB van haar richtsnoeren over pseudonimisering van januari 2025 legt uit dat pseudonimisering het beroep op gerechtvaardigde belangen onder artikel 6(1)(f) gemakkelijker kan maken en verenigbaarheidsbeoordelingen onder artikel 6(4) kan ondersteunen, terwijl andere GDPR-vereisten van toepassing blijven.
Dat is geen bevinding dat elk gepseudonimiseerd gebruik rechtmatig is. Het betekent ook niet dat elk project een belangenafwegingstoets nodig heeft, ongeacht de rechtsgrondslag.
Waar gerechtvaardigd belang de voorgestelde grondslag is, documenteer dan het nagestreefde belang, waarom de verwerking noodzakelijk is, en hoe de organisatie dat belang afweegt tegen de rechten en belangen van individuen. Als de organisatie een nieuw doel voorstelt, beoordeel dat doel dan afzonderlijk in plaats van ervan uit te gaan dat verbeterde beveiliging het verenigbaar maakt.
Een beveiligingsmaatregel kan een juridische beoordeling verbeteren zonder de conclusie ervan te leveren.
Bewijs om mee te nemen naar de goedkeuringsvergadering
Gebruik een bewijsregister dat elke maatregel koppelt aan een eigenaar, een test en een goedkeuringsbeslissing:
- Identificatiekaart. Leg directe identificatoren, quasi-identificatoren en onthullende vrije-tekstpassages vast. Laat zien welke worden vervangen, veralgemeend, uitgesloten of bewust behouden, met redenen.
- Eigendom van attributiegegevens. Stel vast wie de koppeling bewaart en wie identiteiten kan herstellen. Bewaar bewijs van toestemmingen, toegangslogs en de behandeling van uitzonderlijke toegang.
- Doel- en juridische beoordeling. Documenteer het beoogde gebruik, de noodzaak en de passende rechtsgrondslag. Voeg een belangenafwegingstoets toe bij een beroep op gerechtvaardigd belang, en een verenigbaarheidsbeoordeling waar dat relevant is voor secundair gebruik.
- Bewaarregels. Leg vast hoe lang bronbestanden, getransformeerde invoer, uitvoer en koppelingen worden bewaard. Leg uit hoe verwijdering werkt over deze gerelateerde gegevens heen, in plaats van de kluis als een los systeem te behandelen.
- Verwerkers- en doorgifteregelingen. Stel ontvangers en subverwerkers vast, relevante verwerkingslocaties en de toepasselijke contractuele regelingen. Bevestig het doorgiftemechanisme waar regels voor internationale doorgifte van toepassing zijn.
- Heridentificatietests. Test realistische pogingen met behulp van plausibele aanvullende informatie. Neem zeldzame combinaties, herhaalde verwijzingen en correlatie tussen documenten mee, niet alleen of de voor de hand liggende naam is verdwenen.
- Registratie van mislukte uitgaande controles. Bewaar voldoende bewijs om aan te tonen dat mislukte controles de verzending hebben gestopt. Ontwerp die logs zo dat ze geen onnodige dubbele opslag van gevoelige documenttekst worden.
- Herzieningstriggers. Beoordeel opnieuw wanneer datasets, ontvangers, modelaanbieders, koppelingsvereisten of dreigingen veranderen. Wijs iemand de verantwoordelijkheid toe om die veranderingen te herkennen en de goedkeuring opnieuw te openen.
Het onderscheid tussen isolatie, koppeling en inferentie helpt deze tests te ordenen. Onze analyse van identificatierisico's in AI-workflows legt uit waarom het verwijderen van voor de hand liggende identificatoren niet elk risico wegneemt.
Meer artikelen over dit onderwerp zijn verzameld in het overzicht AI-privacy en AVG.
Bronnen en referenties
- EDPB's pseudonymisation guidelines
- UK ICO's guidance on research safeguards
- Pseudonymisation techniques and best practices
- Article 25 of the GDPR
- EDPB adopts pseudonymisation guidelines and paves the way to improve cooperation with competition authorities | European Data Protection Board
- Cross Platform Analytics: How Researchers Join Data Safely
- AI Legal Document Generator | Any Legal Doc in Minutes
Bronnen: Belangrijke juridische claims zijn toegeschreven aan de EDPB's pseudonymisation guidelines over artikel 4(5) en de UK ICO's guidance on research safeguards; technische methodencontext komt uit ENISA's Pseudonymisation techniques and best practices en Article 25 of the GDPR.